La plataforma de IA completa, en tu infraestructura
Tridan AI en instalación propia es la plataforma completa de agentes de IA desplegada en su VPC o en sus propios servidores. Usa modelos locales mediante Ollama, guarda los embeddings en una base de datos vectorial Qdrant propia, usa Supabase propio para los datos de la aplicación y da servicio a toda la empresa mediante organizaciones aisladas. Sus datos nunca se usan para entrenamiento.
- Nube: su propia VPC en AWS, Azure o GCP
- On-premises: sus servidores o una máquina dedicada
your-vpc: despliegue
$ tridan deploy --target your-vpc
Servicios de la plataforma en ejecución
Base de datos vectorial Qdrant lista
Modelos locales cargados vía Ollama
Supabase autoalojado conectado
Aislamiento de organizaciones activo
Tus datos permanecen dentro de tu red
¿Qué es Tridan AI autoalojado?
Tridan AI autoalojado es la opción de despliegue empresarial en la que la plataforma completa, incluidas la base de datos vectorial, la base de datos de la aplicación y el servicio de modelos, se instala en la cuenta cloud o el centro de datos del propio cliente. Nuestro equipo instala, configura y prueba el sistema, y el cliente conserva el control total sobre los datos, el acceso a la red y la elección entre modelos locales y externos.
Leer la documentación del plan autoalojado¿Por qué alojar una plataforma de IA en infraestructura propia?
La instalación propia es para organizaciones cuyos requisitos regulatorios, contractuales o de seguridad no permiten que los datos de clientes, documentos o grabaciones de llamadas salgan de su red. Ofrece control total de los datos, modelos locales para datos sensibles, organizaciones aisladas para toda la empresa y la garantía de que sus datos nunca se usan para entrenamiento.
Control total de los datos
Ejecuta todo en tu VPC o en tus instalaciones. Tus datos permanecen dentro de tu red, accesibles solo para las personas y sistemas que autorices.
Modelos locales para datos sensibles
Ejecute modelos abiertos mediante Ollama en su propio hardware, para que prompts y documentos nunca salgan de su red.
Organizaciones multi-tenant
Organizaciones, roles y permisos aislados, un solo despliegue da servicio seguro a todos los equipos de tu empresa.
Nunca se usan para entrenamiento
Tus datos nunca se usan para entrenar modelos. Soberanía total para industrias reguladas y requisitos de cumplimiento estrictos.
- ClientesSolicitudes por chat y teléfono
- Sus agentesSe ejecutan en sus servidores
- Ollama o gatewayModelos locales o externos vía su gateway
- Sus datosPermanecen en su red
- Su equipoLo opera y lo audita
¿Qué incluye un despliegue autoalojado?
Cada instalación incluye la plataforma completa de Tridan AI, una base de datos vectorial Qdrant propia para embeddings y búsqueda de documentos, modelos locales mediante Ollama con acceso opcional a OpenAI, Anthropic, Meta y DeepSeek a través de sus APIs, y un stack de Supabase propio para autenticación y datos de la aplicación. Lo desplegamos y configuramos todo en su infraestructura.
La plataforma Tridan AI completa
Agentes de IA personalizados, chat y búsqueda sobre tus documentos, la plataforma completa, funcionando de forma privada para tu organización.
Base de datos vectorial Qdrant
La búsqueda vectorial autoalojada mantiene tus embeddings y el conocimiento de tus documentos dentro de tu propia red.
Modelos locales vía Ollama
Ejecute modelos abiertos por completo en su hardware o combine OpenAI, Anthropic, Meta y DeepSeek por agente.
Supabase autoalojado
La autenticación y los datos de la aplicación se ejecutan en un stack de Postgres que posees y controlas.
Dos formas de ejecutar tus modelos
Mantenga todo dentro de su red o combine su instalación privada con modelos externos líderes; la elección depende de sus preferencias de privacidad y coste.
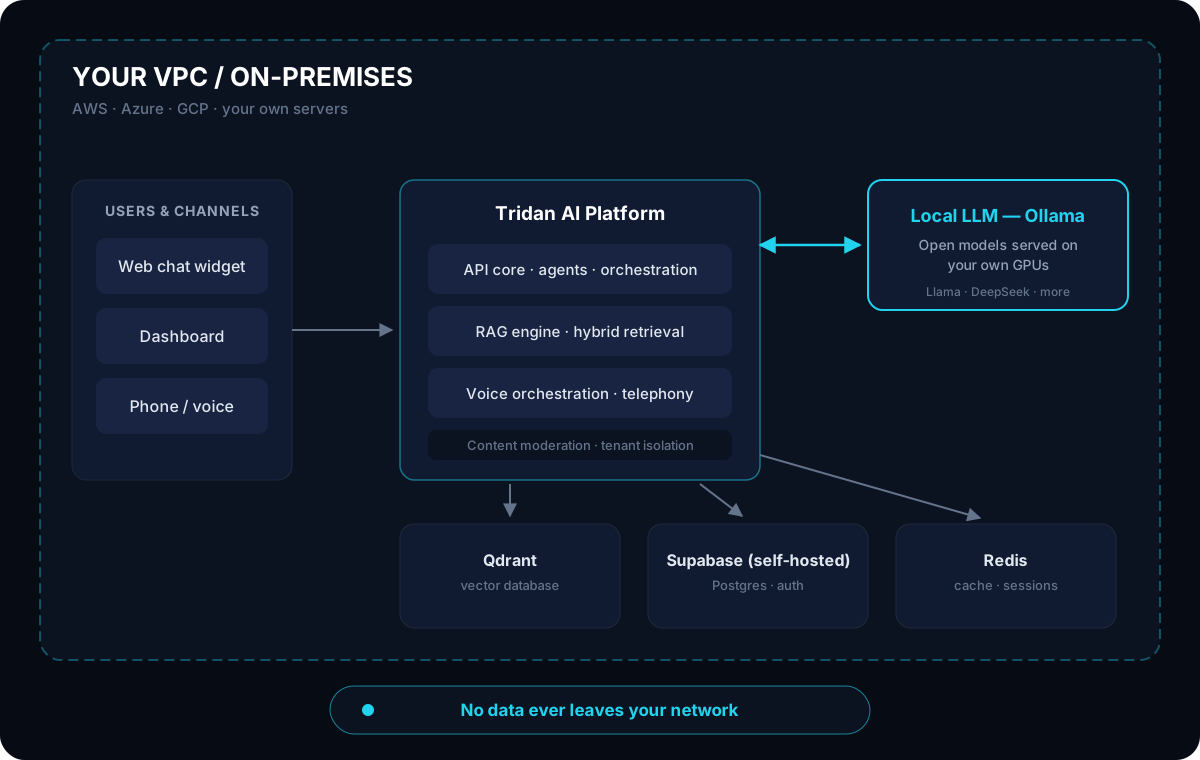
Opción 1: Totalmente privado, LLM dentro de su VPC
- Ningún dato sale nunca de tu red.
- El LLM, la base de datos vectorial y todos los datos residen en tu infraestructura.
- Modelos abiertos locales servidos vía Ollama.
- Costes de GPU más altos en los proveedores de nube.
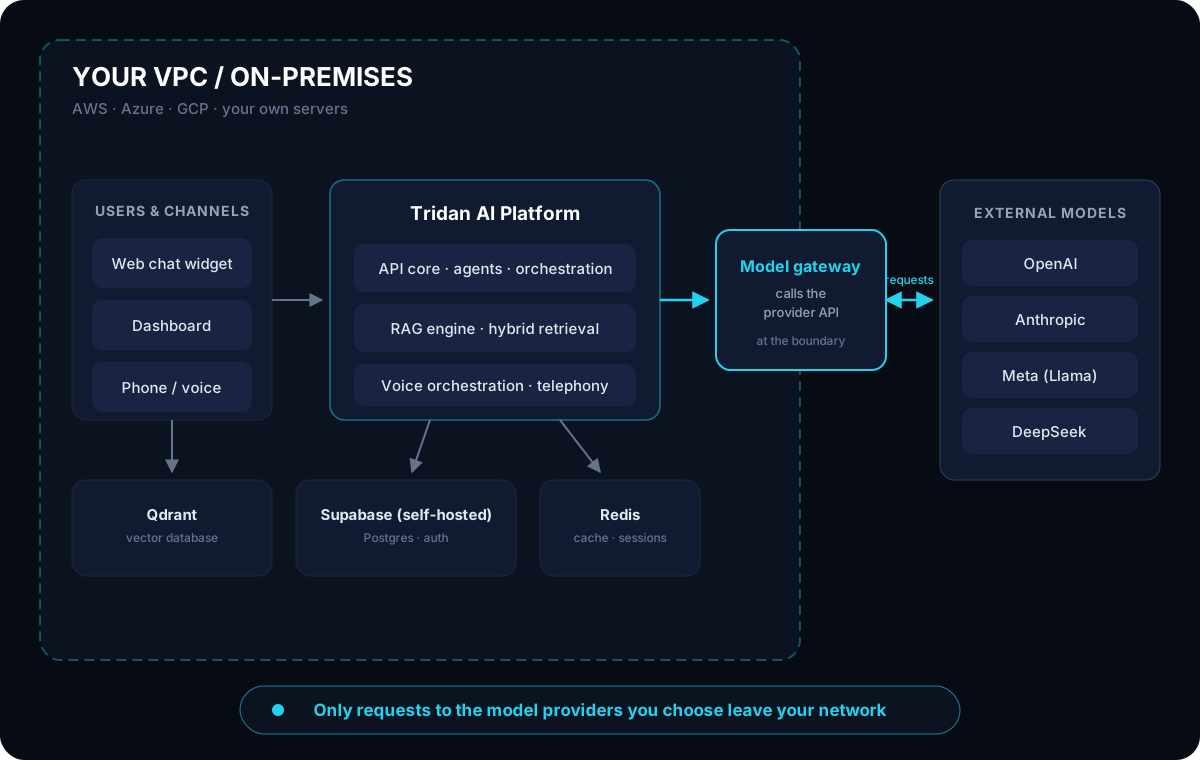
Opción 2: Modelos externos
- Usa 4 modelos de IA líderes: OpenAI, Anthropic, Meta y DeepSeek.
- Menor coste de infraestructura que ejecutar modelos locales en tus propias GPU.
- Usted elige los proveedores y sus condiciones comerciales, por agente.
- Los prompts y el contexto que incluyen los procesa el proveedor de modelos externo que usted elija.
¿Nube gestionada o instalación propia: qué despliegue encaja?
Ambas ediciones ejecutan la misma plataforma y los mismos agentes. La tabla compara dónde residen los datos, qué modelos están disponibles y quién opera cada cosa.
Desliza hacia el lado para ver la tabla completa
| Nube gestionada (SaaS) | Instalación propia (VPC / on-premises) | |
|---|---|---|
| Dónde residen los datos | Plataforma alojada por Tridan AI, en un inquilino aislado por cliente | Su VPC o su centro de datos; nada sale de su red salvo que elija modelos externos |
| Modelos | OpenAI, Anthropic, Meta y DeepSeek, seleccionables por agente | Modelos abiertos locales mediante Ollama, más las mismas cuatro familias a través de sus APIs |
| Llamadas a modelos externos | Se envían a las APIs empresariales de los proveedores, según las condiciones de tratamiento de datos publicadas | Opcional: solo modelos locales o los proveedores externos que permita por agente |
| Quién lo opera | Tridan AI ejecuta, supervisa y actualiza la plataforma | Su equipo opera la infraestructura; Tridan AI instala, configura y da soporte al sistema |
| Actualizaciones | Continuas, aplicadas por Tridan AI sin paradas que programar | Entregadas como versiones que usted aplica con nuestro soporte, según su propio calendario |
| Ideal para | Equipos que quieren empezar hoy con un plan, incluido el gratuito, sin infraestructura | Organizaciones reguladas y empresas que deben mantener datos, modelos y grabaciones dentro de su propia red |
Elija la nube gestionada para empezar rápido y la instalación propia cuando sus datos deban permanecer en su red; los agentes y las funciones son los mismos en ambas.
Del arranque a producción en cinco pasos
Nuestro equipo te guía en cada paso, desde la configuración inicial de la infraestructura hasta el despliegue final, asegurando que se cumplan todos los requisitos de seguridad y cumplimiento.
Configuración de la infraestructura
Preparamos tu VPC o tu entorno on-premises para el despliegue.
Configuración
Los parámetros de seguridad y las integraciones de sistemas se configuran según tus requisitos.
Integración de datos
Conecta de forma segura bases de datos y aplicaciones internas a la plataforma.
Control de acceso
Define organizaciones, roles, permisos y mecanismos de autenticación.
Despliegue y pruebas
Verificamos la funcionalidad y el cumplimiento de seguridad antes de la puesta en marcha.
Preguntas frecuentes sobre la instalación propia
¿Qué infraestructura necesitamos para la instalación propia?
La plataforma funciona en su VPC en una nube pública como AWS, Azure o GCP, o en sus instalaciones, en sus propios servidores o en una máquina dedicada. Los requisitos dependen de la opción de modelos: los modelos locales mediante Ollama necesitan GPU, mientras que la opción con modelos externos funciona en servidores CPU estándar. Dimensionamos el entorno juntos en la llamada de despliegue.
¿Podemos operar la plataforma sin ningún proveedor de IA externo?
Sí. En la opción totalmente privada, el modelo de lenguaje, la base de datos vectorial Qdrant y todos los datos de la aplicación funcionan dentro de su red, con modelos abiertos mediante Ollama. Ningún prompt, documento ni grabación sale de su infraestructura. El coste es la GPU: los modelos locales capaces necesitan hardware dedicado, por eso algunos clientes usan modelos locales para los datos sensibles y modelos externos para el resto.
¿Qué datos llegan a un proveedor de modelos externo?
Solo lo que un agente envía cuando usa un modelo externo: la conversación, sus instrucciones y los pasajes de conocimiento recuperados, a través de la API empresarial del proveedor y bajo sus condiciones. Los agentes con modelos locales mediante Ollama no envían nada fuera de su red, y usted elige el modelo de cada agente.
¿Puede un despliegue atender a varios equipos o empresas?
Sí. Las organizaciones multiinquilino permiten que un único despliegue autoalojado atienda a cada equipo, departamento o filial con documentos, agentes, conversaciones y usuarios aislados. Los roles y permisos se gestionan por organización, y la autenticación se ejecuta en el sistema Supabase autoalojado que usted controla, así que puede conectarlo a su sistema de identidad existente durante el paso de control de acceso del despliegue.
¿Quién instala y mantiene la plataforma?
Nuestro equipo prepara el entorno, instala y configura el sistema, conecta sus fuentes de datos, configura organizaciones y control de acceso y prueba la funcionalidad y la seguridad antes de la puesta en marcha. Después, su equipo opera la infraestructura mientras nosotros proporcionamos actualizaciones y soporte dentro del plan autoalojado. La documentación describe los pasos del despliegue y las responsabilidades de cada parte.
¿Cómo se tarifica la instalación propia?
Los despliegues autoalojados se tarifican de forma individual, porque el alcance depende de la infraestructura, la opción de modelos, el número de organizaciones, la telefonía y las integraciones implicadas. La página de precios explica la estructura de planes, y tras una llamada de despliegue enviamos una oferta por escrito que cubre instalación, configuración y soporte continuo, para que pueda compararla con la nube gestionada antes de decidir.
Última actualización · Revisado por Nemanja Milivojevic, fundador
Ejecuta Tridan AI en tus propios términos
Habla con nuestro equipo sobre desplegar la plataforma en tu VPC o en tus instalaciones, te guiaremos por la arquitectura, el dimensionamiento y los plazos.